Trí tuệ nhân tạo – Kiến trúc transformer giải thích đơn giản cho người mới: Tự chú ý và Mã hóa vị trí bằng ngôn ngữ đời thường
Trí tuệ nhân tạo bao quanh chúng ta, nhưng nhiều bước đột phá gần đây đều bắt nguồn từ một thiết kế: transformer. Nếu bạn từng thắc mắc vì sao chatbot, công cụ dịch và trợ lý viết hiện đại hiểu từ ngữ giỏi đến vậy, câu trả lời bắt đầu ở kiến trúc transformer giải thích đơn giản cho người mới. Bài viết này đi qua các ý tưởng lớn bằng ngôn ngữ đời thường, tập trung vào hai thành phần then chốt: tự chú ý (self-attention) và mã hóa vị trí (positional encoding).
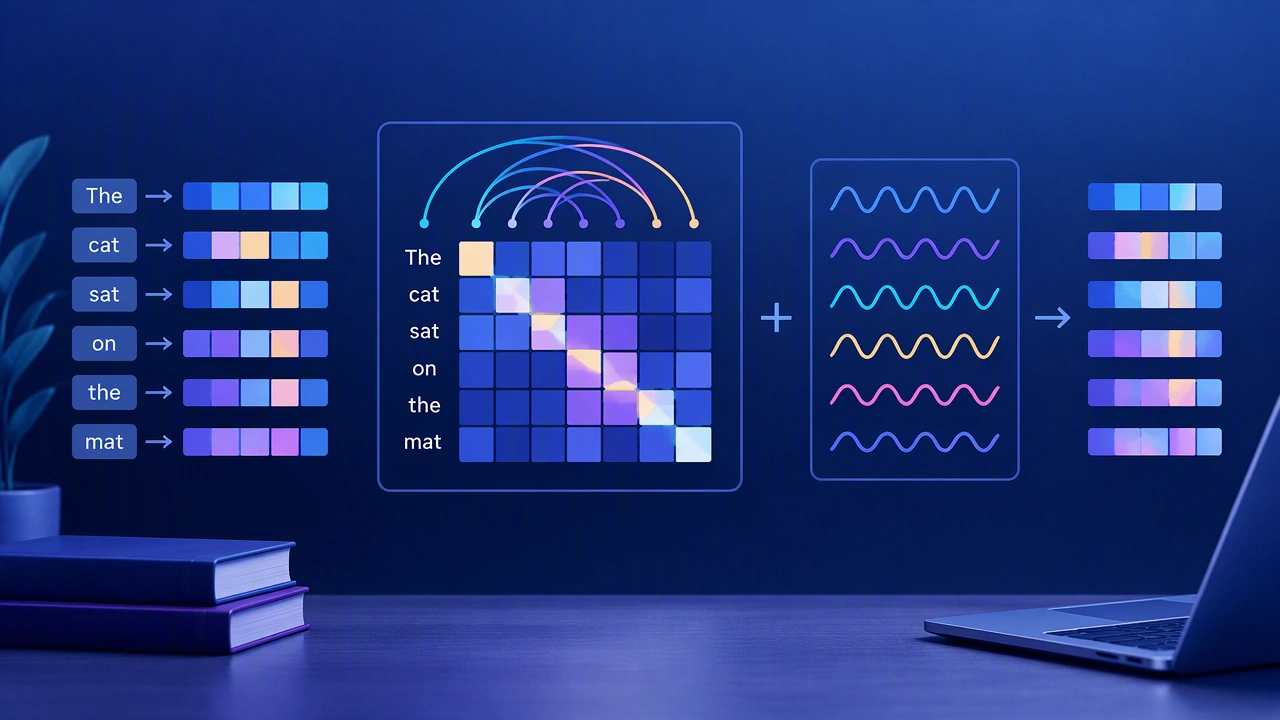
Ở mức khái quát, transformer đọc cả một câu cùng lúc và học cách mỗi từ liên hệ với mọi từ khác. Thay vì di chuyển cứng nhắc từ trái sang phải, nó cho phép mô hình cân nhắc token nào quan trọng nhất tại mỗi vị trí. Sự thay đổi đơn giản đó, từ trình tự cứng sang chú ý linh hoạt, đã mở ra khả năng hiểu ngôn ngữ sâu sắc hơn rất nhiều.
Transformer làm gì với văn bản
Khi transformer gặp một câu, trước tiên nó biến mỗi từ hoặc subword thành một biểu diễn số gọi là embedding. Hãy nghĩ embedding như một điểm trong không gian nhiều chiều, nơi các nghĩa tương tự sống gần nhau. Các embedding này trở thành các vector mà mô hình có thể di chuyển, trộn và so sánh. Từ đó, transformer xếp chồng nhiều lớp để tinh chỉnh các vector đó từng bước, xây dựng ý nghĩa từ cú pháp đến ngữ nghĩa.
Hai ý tưởng tạo nên sức mạnh. Thứ nhất, tự chú ý quyết định mỗi token nên chú ý đến các token khác nhiều đến mức nào. Thứ hai, mã hóa vị trí cho mô hình biết mỗi token ngồi ở đâu trong chuỗi, vì cơ chế chú ý tự nó không biết thứ tự. Với hai công cụ này, mô hình có thể học các mẫu như chủ ngữ-động ngữ khớp nhau, tham chiếu khoảng cách xa, và thậm chí những thay đổi sắc thái tinh tế.
Tự chú ý: để từ ngữ tự chọn ngữ cảnh
Hãy tưởng tượng bạn đang đọc câu: “Con mèo ngồi trên tấm thảm vì nó mềm.” Từ “nó” có thể chỉ con mèo hoặc tấm thảm. Tự chú ý giúp mô hình quyết định bằng cách tạo ba vector cho mỗi token: truy vấn (query), khóa (key) và giá trị (value).
- Truy vấn hỏi: “Tôi đang tìm gì?”
- Khóa thông báo: “Đây là những gì tôi chứa.”
- Giá trị cung cấp: “Đây là thông tin tôi có thể chia sẻ.”
Với mỗi token, mô hình so sánh truy vấn của nó với khóa của tất cả token, kể cả chính nó. Các phép so sánh này tạo ra điểm chú ý. Sau bước chia tỷ lệ và hàm softmax, các điểm số trở thành trọng số để tổng hợp các giá trị. Kết quả là một biểu diễn mới pha trộn ngữ cảnh liên quan nhất.
Tại sao điều này quan trọng: chú ý dựa trên nội dung. Mô hình không chỉ dựa vào các từ gần đó; nó có thể nhảy xuyên câu để nối đại từ với danh từ, hoặc động từ với chủ ngữ, ngay cả khi chúng ở xa nhau. Sự linh hoạt đó là lý do cốt lõi khiến transformer hoạt động tốt với các văn bản dài và phức tạp.
Tự chú ý đa đầu: nhiều góc nhìn cùng lúc
Transformer không sử dụng một phép chú ý duy nhất. Nó chạy nhiều phép song song, gọi là đầu chú ý (attention heads). Mỗi đầu học một mẫu khác nhau. Một đầu có thể theo dõi cú pháp, một đầu khác có thể liên kết từ đồng nghĩa, và một đầu khác có thể tập trung vào phủ định hoặc số lượng. Bằng cách kết hợp các đầu này, mô hình thu thập nhiều loại ngữ cảnh cùng lúc.
Sau khi các đầu tính toán xong kết quả, một mạng neural nhỏ trộn đầu ra của chúng. Điều này mang lại cho mô hình cái nhìn phong phú hơn về câu, giống như nhìn qua nhiều bộ lọc, mỗi bộ làm nổi bật một đặc trưng khác nhau.
Mã hóa vị trí: cho mô hình cảm nhận về trật tự
Chú ý về bản chất không quan tâm đến thứ tự. Nếu bạn xáo trộn các từ, điểm chú ý sẽ giống nhau. Nhưng thứ tự từ rất quan trọng trong ngôn ngữ. “Chó cắn người” và “người cắn chó” có nghĩa rất khác nhau. Mã hóa vị trí giải quyết vấn đề này bằng cách thêm tín hiệu đánh dấu vị trí của mỗi token.
Các transformer ban đầu sử dụng tín hiệu cố định dựa trên sóng sin và cosin ở các tần số khác nhau. Các thiết kế sau này học embedding vị trí trực tiếp từ dữ liệu. Dù bằng cách nào, thông điệp vẫn giống nhau: mô hình nhận được gợi ý về vị trí, để nó có thể phân biệt đầu với cuối, gần với xa, và bắt đầu với kết thúc.
Bạn có thể nghĩ mã hóa vị trí như những nhãn nhỏ được thêm vào mỗi embedding. Những nhãn này cho phép mô hình nói “Tôi là token số 5” hoặc “Tôi ở gần đầu câu”, trong khi vẫn để cơ chế chú ý quyết định token nào cần tập trung. Kết quả là sự cân bằng: vị trí cung cấp cấu trúc, và chú ý cung cấp sự tập trung.
Các thành phần hoạt động cùng nhau trong một lớp
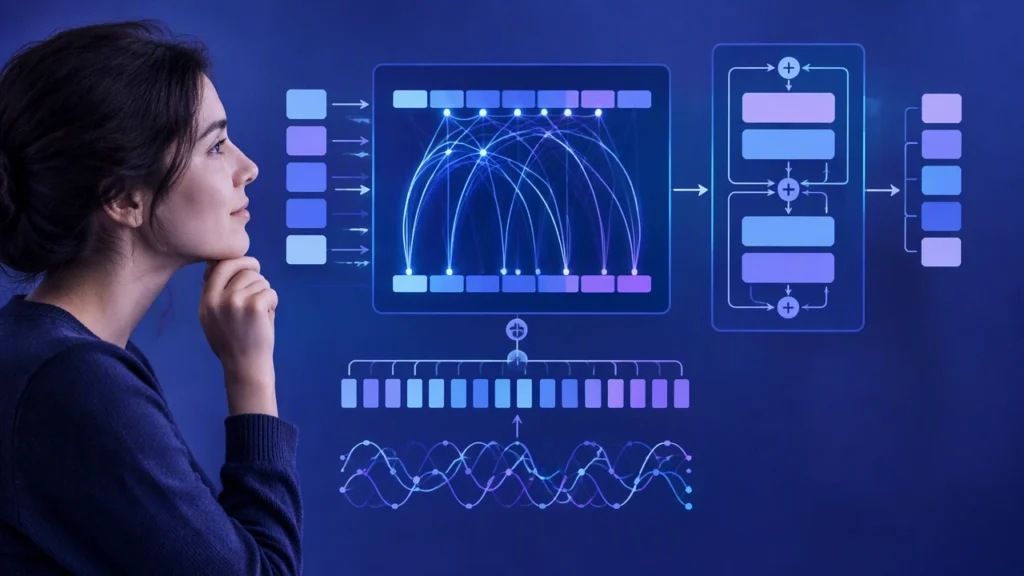
Một lớp transformer điển hình theo mô hình có thể lặp lại. Đầu tiên, tự chú ý thu thập ngữ cảnh. Sau đó, một mạng feed-forward nhỏ xử lý mỗi token độc lập để chuyển hóa biểu diễn của nó. Xung quanh cả hai bước, các kết nối dư (residual connections) và chuẩn hóa (normalization) giúp giữ quá trình huấn luyện ổn định và gradient khỏe mạnh. Xếp chồng nhiều lớp cho phép mô hình chuyển từ các mẫu đơn giản đến các ý tưởng trừu tượng.
Trong các mô hình chỉ có encoder, lớp xếp chồng xây dựng sự hiểu biết sâu cho các tác vụ như phân loại hoặc tìm kiếm. Trong các mô hình chỉ có decoder, vốn hỗ trợ nhiều trợ lý ngôn ngữ hiện đại, chú ý thường bị che (masked) để mỗi token chỉ có thể nhìn thấy các token trước nó trong quá trình tạo. Trong các mô hình encoder-decoder, decoder chú ý đến đầu ra của encoder, điều này hữu ích cho dịch thuật hoặc tóm tắt.
Tại sao thiết kế này mở rộng tốt đến vậy
Transformer có khả năng song song hóa cao. Trong quá trình huấn luyện, phép chú ý trên một chuỗi có thể chạy trên phần cứng hiện đại với batch lớn, giúp việc học nhanh hơn và ổn định hơn. Khả năng mở rộng đó, kết hợp với khả năng mô hình hóa các mối quan hệ khoảng cách xa của chú ý, là lý do lớn khiến transformer trở thành trụ cột của xử lý ngôn ngữ tự nhiên hiện đại.
Quan trọng không kém, transformer có khả năng khái quát hóa. Kiến trúc cốt lõi tương tự hoạt động cho văn bản, mã nguồn, hình ảnh, âm thanh và nhiều hơn nữa, với các điều chỉnh cụ thể cho từng tác vụ. Tự chú ý học các mẫu có thể chuyển giao giữa các lĩnh vực, đó là lý do tại sao tinh chỉnh một transformer đã được huấn luyện trư���c có thể giải quyết nhiều vấn đề với relatively ít dữ liệu bổ sung.
Mô hình tư duy đơn giản cho người mới
Nếu bạn mới bắt đầu, đây là cách hình dung ngắn gọn:
- Embeddings biến từ thành vector.
- Mã hóa vị trí thêm thông tin về thứ tự.
- Tự chú ý trộn mỗi token với các token liên quan nhất.
- Tự chú ý đa đầu thực hiện điều này với nhiều góc nhìn cùng lúc.
- Các lớp feed-forward tinh chỉnh biểu diễn của mỗi token.
- Các lớp xếp chồng xây dựng sự hiểu biết sâu hơn từng bước.
Với cấu trúc này, mô hình có thể học ngữ pháp, kiến thức, mẫu suy luận và phong cách, tất cả từ dữ liệu và phản hồi.
Điều cần ghi nhớ
Sức mạnh của transformer đến từ việc cho phép mỗi token quyết định, dựa trên nội dung, token nào khác quan trọng, và từ việc cho mô hình biết các token đó ngồi ở đâu. Tự chú ý cung cấp ngữ cảnh linh hoạt, khoảng cách xa. Mã hóa vị trí cung cấp thứ tự. Cùng nhau, chúng tạo ra một công thức đơn giản nhưng mạnh mẽ, có thể mở rộng và khái quát hóa. Đó là lý do tại sao kiến trúc transformer giải thích đơn giản cho người mới thường bắt đầu với hai ý tưởng này: chú ý cho ý nghĩa, và vị trí cho cấu trúc.