Trí tuệ nhân tạo: học tăng cường huấn luyện quản trò và robot như thế nào
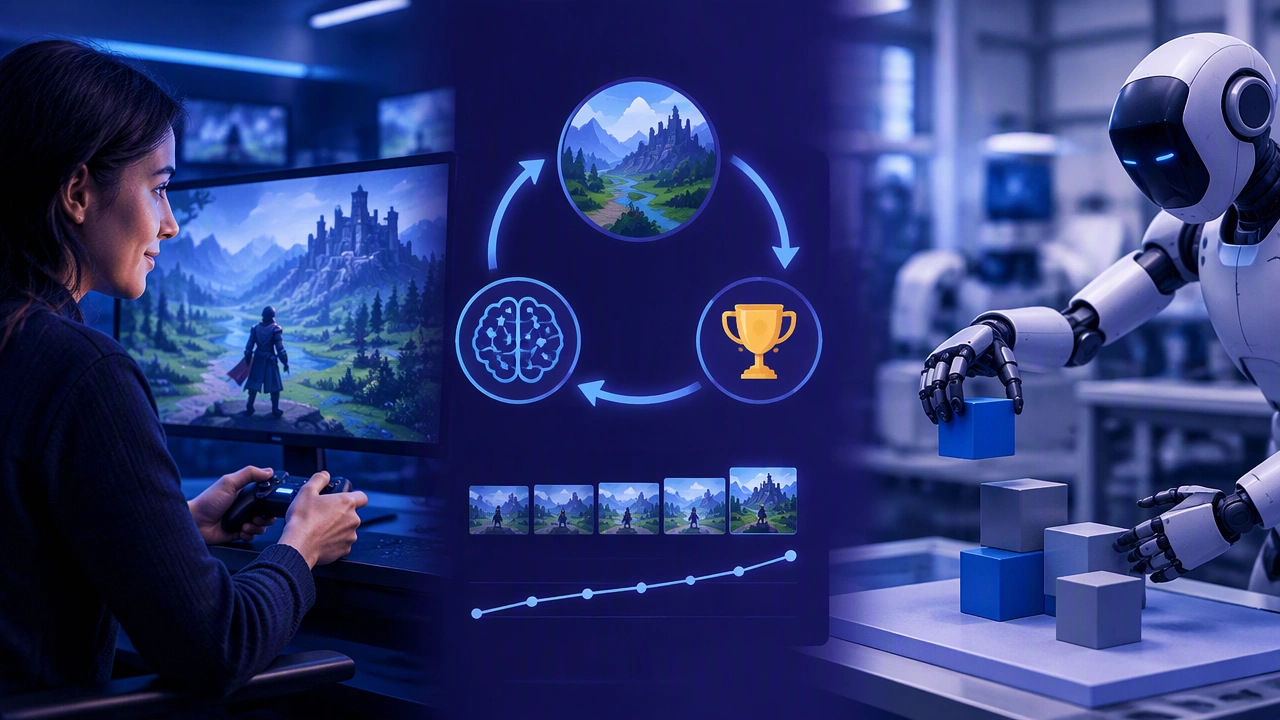
Trí tuệ nhân tạo thường có vẻ bí ẩn vì chúng ta không thể quan sát cách máy tính suy nghĩ. Học tăng cường giúp hình dung quá trình này dễ hơn. Một tác nhân học bằng cách thử các hành động, quan sát kết quả và điều chỉnh lựa chọn để ngày càng nhận nhiều phần thưởng hơn. Cùng một ý tưởng cơ bản có thể giúp người chơi ảo cải thiện ở trò chơi bàn và giúp robot vật lý học cách nhặt một vật mà không làm rơi.
Học tăng cường là gì
Học tăng cường là một nhánh của h���c máy, trong đó người học được gọi là tác nhân tương tác với môi trường và nhận phản hồi dưới dạng phần thưởng hoặc hình phạt dạng số. Tác nhân không nhận một danh sách câu trả lời đúng cho mọi tình huống. Thay vào đó, nó khám phá, đánh giá kết quả và xây dựng một chiến lược có xu hướng tạo ra kết quả tốt.
Môi trường có thể là bàn cờ, một thế giới mô phỏng hoặc một căn phòng có robot. Tác nhân chọn một hành động, môi trường thay đổi và một quan sát mới xuất hiện. Phần thưởng có thể dương khi ghi điểm hoặc đạt mục tiêu, và âm khi đi nước phạm luật hoặc va vào vật cản. Qua nhiều lượt, tác nhân học được hành động nào hữu ích trong tình huống nào.
Vòng lặp phần thưởng
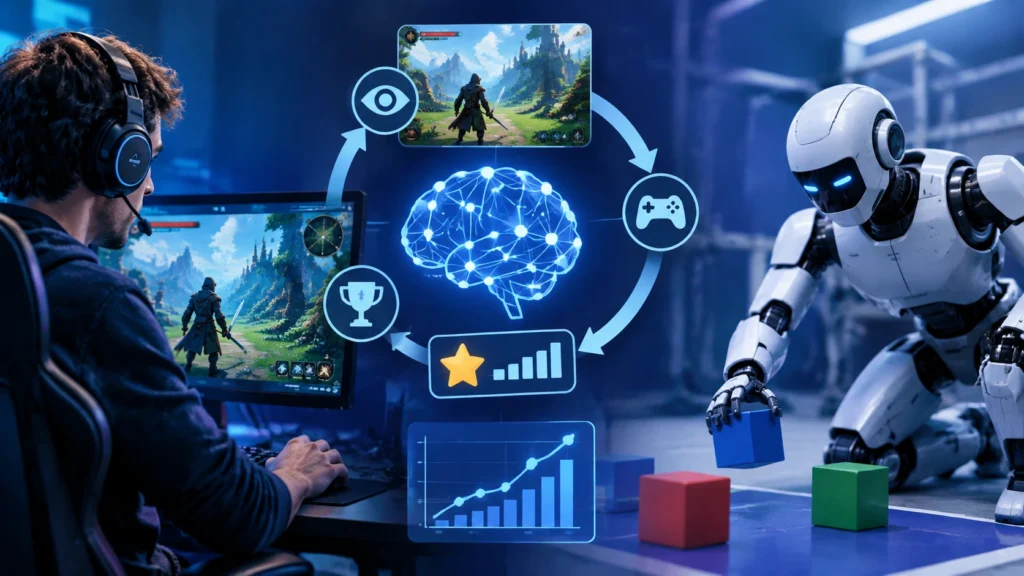
Cơ chế trung tâm là một vòng phản hồi:
- Quan sát: Tác nhân đọc trạng thái hiện tại, chẳng hạn vị trí các quân cờ hoặc góc các khớp của robot.
- Hành động: Nó chọn một hành động trong các lựa chọn khả dụng.
- Đánh giá: Môi trường trả về một phần thưởng và một quan sát mới.
- Cập nhật: Tác nhân điều chỉnh chính sách, tức là quy tắc chọn hành động trong các trạng thái tương lai.
Phần thưởng có thể tức thời hoặc trì hoãn. Tác nhân trong trò chơi có thể nhận phần thưởng nhỏ khi nhặt vật phẩm và phần thưởng lớn khi thắng vài nước sau đó. Robot có thể nhận phần thưởng rất nhỏ khi tiến gần mục tiêu hơn và phần thưởng lớn khi hoàn thành nhiệm vụ. Vì phần thưởng tương lai quan trọng, tác nhân phải cân bằng lợi ích ngắn hạn với thành công dài hạn.
Khám phá và khai thác
Việc học cần cân bằng giữa khám phá và khai thác. Khai thác nghĩa là chọn hành động hiện tại có vẻ tốt nhất. Khám phá nghĩa là thử các phương án thay thế có thể tốt hơn nhưng kém chắc chắn hơn. Nếu tác nhân chỉ khai thác, nó có thể rơi vào một chiến lược tầm thường. Nếu chỉ khám phá, nó có thể không bao giờ ổn định với một kế hoạch đáng tin cậy.
Các phương pháp đơn giản dùng quy tắc epsilon-greedy: phần lớn thời gian tác nhân chọn hành động tốt nhất đã biết, và với xác suất nhỏ, nó chọn một hành động ngẫu nhiên. Các phương pháp nâng cao hơn ước lượng sự không chắc chắn hoặc hoạch định trước. Dù theo cách nào, mục tiêu vẫn là thu thập kinh nghiệm hữu ích trong khi tiếp tục cải thiện.
Từ thử nghiệm đến chính sách
Một chính sách ánh xạ các quan sát sang hành động. Những ngày đầu huấn luyện, chính sách có thể ngẫu nhiên và tạo ra nhiều thất bại. Khi kinh nghiệm tích lũy, tác nhân học các giá trị ước lượng mức độ tốt của một trạng thái hoặc hành động. Từ đó, nó có thể ưu tiên các hành động dẫn đến trạng thái có kỳ vọng hoàn vốn cao hơn.
Các phương pháp dựa trên giá trị, như Q-learning, ước lượng giá trị của việc thực hiện một hành động trong một trạng thái. Các phương pháp dựa trên chính sách trực tiếp điều chỉnh xác suất của các hành động. Các phương pháp actor-critic kết hợp cả hai ý tưởng: một actor chọn hành động trong khi một critic đánh giá chúng. Những cách tiếp cận này khác nhau về chi tiết, nhưng đều dựa trên cùng nguyên tắc cải thiện hành vi thông qua phản hồi.
Vì sao trò chơi là môi trường huấn luyện tự nhiên
Trò chơi cung cấp quy tắc rõ ràng, các lượt thử có thể lặp lại và điểm số chính xác. Điều này khiến chúng lý tưởng để nghiên cứu ứng dụng học tăng cường trong trò chơi và robot. Một tác nhân trò chơi có thể chơi hàng nghìn hoặc hàng triệu lượt trong trình mô phỏng, thử các chiến lược sẽ chậm hoặc rủi ro trong thế giới thực.
Trong các trò chơi bàn, tác nhân học cách đánh giá vị trí, dự đoán phản ứng của đối thủ và hoạch định trước nhiều nước. Trong các trò chơi kiểu arcade, nó học cách kết nối các hành động ngắn như di chuyển hoặc nhảy với kết quả dài hạn như điểm cao. Môi trường cung cấp tín hiệu sạch: điểm số thay đổi, một màn chơi hoàn thành hoặc trò chơi kết thúc.
Trò chơi cũng bộc lộ những giới hạn quan trọng. Một điểm số hoàn hảo trong trình mô phỏng có thể phụ thuộc vào các giả định không đúng ở nơi khác. Tác nhân có thể khai thác các điểm bất thường của engine trò chơi thay vì học một kỹ năng tổng quát hữu ích. Vì vậy, thiết kế tốt bao gồm các màn đa dạng, thông tin ẩn hoặc điều kiện ngẫu nhiên để chính sách học được trở nên vững chắc.
Dạy robot qua kinh nghiệm
Robot đối mặt với một bài học khó hơn. Hành động của chúng ảnh hưởng đến vật thể vật lý, cảm biến có nhiều nhiễu và sai sót có thể làm hỏng thiết bị. Học tăng cường vẫn áp dụng, nhưng huấn luyện thường bắt đầu trong mô phỏng. Một cánh tay mô phỏng có thể luyện cách nắm, giữ thăng bằng hoặc điều hướng mà không làm hỏng bộ phận hay gây nguy hiểm cho người.
Khi một chính sách hoạt động đáng tin cậy trong mô phỏng, kỹ sư có thể chuyển nó sang robot thật trong khi theo dõi an toàn. Domain randomization thay đổi ánh sáng, ma sát, khối lượng và vị trí camera trong quá trình huấn luyện, giúp chính sách thích nghi khi thực tế khác với trình mô phỏng. Thiết kế phần thưởng cẩn thận cũng rất cần thiết. Phần thưởng cho việc di chuyển nhanh phải được cân bằng với các hình phạt cho va chạm, lực quá lớn hoặc chuyển động không ổn định.
Các nhiệm vụ robot thường gặp bao gồm nhặt và đặt vật, đi trên địa hình gồ ghề, đi theo một lộ trình và phối hợp nhiều khớp để rót chất lỏng hoặc mở cửa. Trong mỗi trường hợp, tác nhân học một chuỗi các quyết định nhỏ tạo ra một hành vi tổng thể hữu ích.
Những thách thức còn tồn tại
Học tăng cường mạnh mẽ, nhưng không tự động. Phần thưởng được chọn kém có thể dẫn đến hành vi đáng ngạc nhiên. Nếu mục tiêu duy nhất là thu thập điểm, tác nhân có thể tìm đường tắt để nhận phần thưởng mà không hoàn thành nhiệm vụ dự kiến. Điều này đôi khi được gọi là reward hacking, và cho thấy tại sao các mục tiêu phải được chỉ định cẩn thận.
Việc huấn luyện cũng có thể kém hiệu quả mẫu, đòi hỏi nhiều tương tác trước khi hành vi trở nên ổn định. Các tương tác trong thế giới thực tốn kém, vì vậy nhà nghiên cứu sử dụng trình mô phỏng, minh họa và dữ liệu ngoại tuyến để giảm rủi ro. An toàn, khả năng giải thích và công bằng rất quan trọng khi các chính sách học được ảnh hưởng đến con người hoặc vận hành máy móc đắt tiền.
Một cách thực tế để hiểu ý tưởng
Hãy tưởng tượng một robot nhỏ học cách đến trạm sạc. Ban đầu nó di chuyển ngẫu nhiên và thỉnh thoảng va vào tường. Mỗi bước về phía trạm kiếm một phần thưởng dương nhỏ; va chạm nhận hình phạt. Qua nhiều lần thử, robot học một chính sách ưu tiên lối đi thoáng và các lượt rẽ hiệu quả. Cùng vòng lặp này giải thích một tác nhân trò chơi phát hiện nước mở mạnh hoặc một cánh tay robot học cách cầm vững.
Học tăng cường biến việc luyện tập thành sự cải thiện có thể đo lường. Bằng cách kết nối quan sát, hành động và phần thưởng, các tác nhân có thể làm chủ trò chơi và điều khiển robot thông qua kinh nghiệm thay vì chỉ dẫn tường minh. Hiểu vòng phản hồi này là nền tảng hữu ích để theo dõi các tiến bộ hiện tại của trí tuệ nhân tạo và đánh giá nơi các hệ thống này đáng tin cậy, nơi chúng cần giám sát và nơi việc kiểm tra cẩn thận v��n quan trọng.