Học có giám sát vs không giám sát giải thích với ví dụ về trí tuệ nhân tạo
Hệ thống trí tuệ nhân tạo thường học từ dữ liệu thay vì chỉ tuân theo quy tắc cứng nhắc. Hai điểm xuất phát cơ bản là học có giám sát, nơi mô hình học từ các câu trả lời đã được gán nhãn, và học không giám sát, nơi mô hình tìm kiếm cấu trúc dữ liệu mà không cần nhãn. Hướng dẫn học có giám sát vs không giám sát giải thích với ví dụ này sẽ cho bạn thấy mỗi cách tiếp cận hoạt động như thế nào và khi nào nên sử dụng chúng.
Machine Learning thực sự làm gì
Machine learning (học máy) là cách cải thiện hiệu suất trong một nhiệm vụ bằng cách nghiên cứu dữ liệu. Thay vì viết quy tắc cho từng trường hợp, bạn cung cấp cho hệ thống các mẫu để nó có thể tổng quát hóa. Mô hình điều chỉnh các tham số nội bộ khi quan sát dữ liệu mẫu, sau đó sử dụng các thông số đó để đưa ra dự đoán hoặc tổ chức thông tin mới.
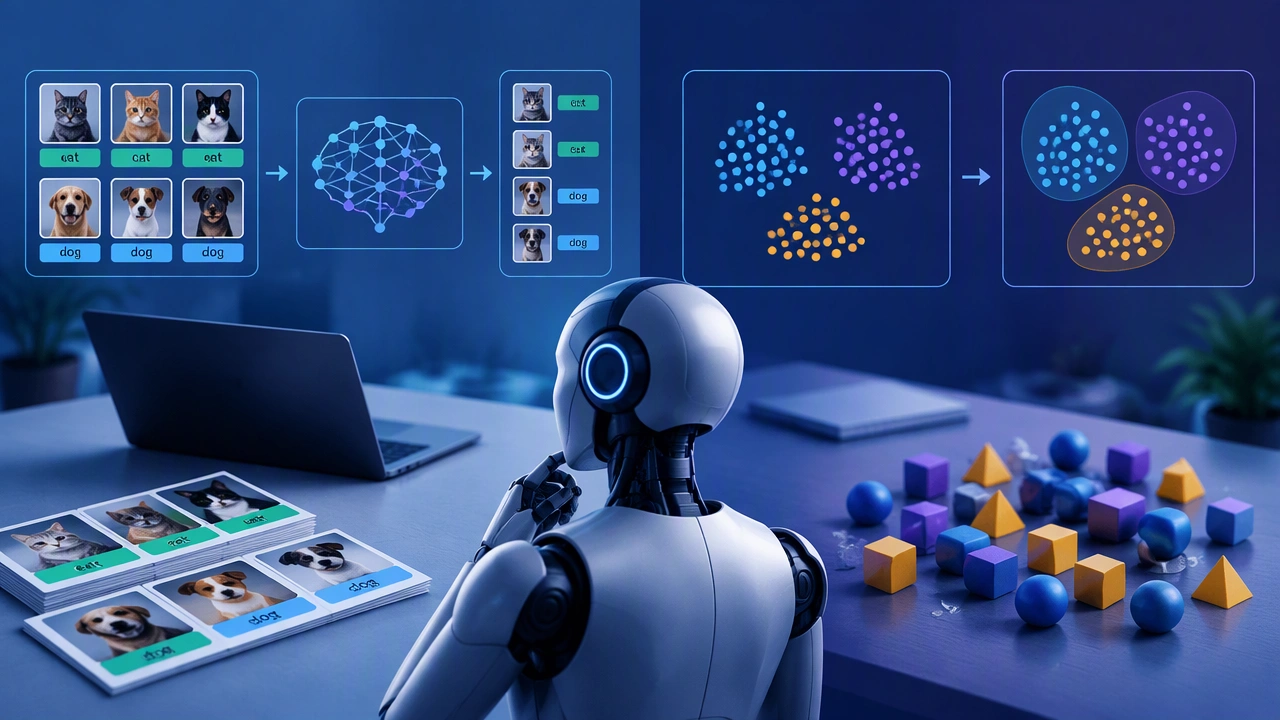
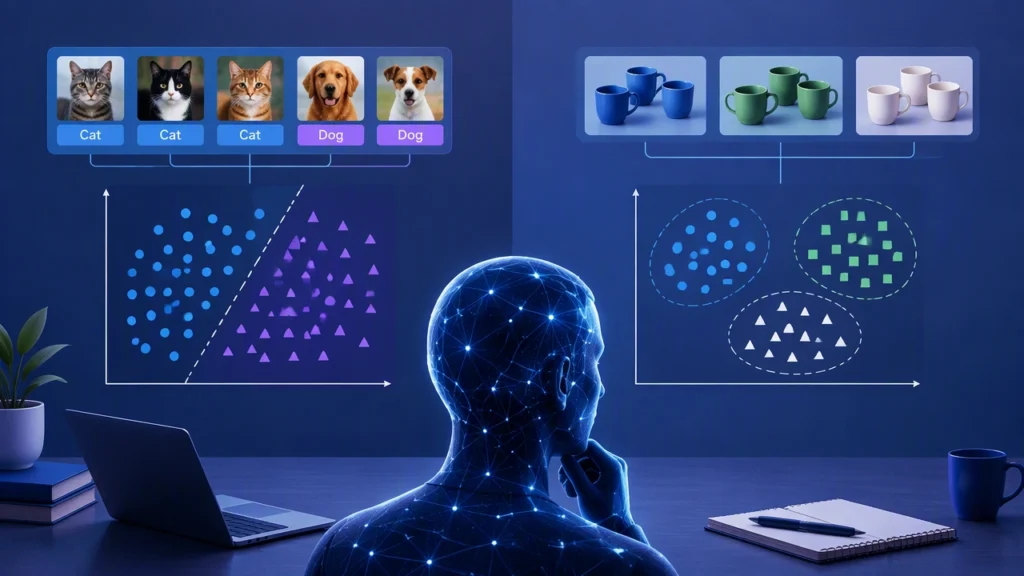
Sự khác biệt chính giữa hai cách tiếp cận chính nằm ở loại phản hồi có sẵn trong quá trình huấn luyện. Học có giám sát sử dụng kết quả đúng trong quá trình huấn luyện. Học không giám sát chỉ nhận đầu vào và phải tự khám phá cấu trúc hữu ích. Việc lựa chọn giữa hai phương pháp phụ thuộc vào câu hỏi bạn đang đặt ra, dữ liệu bạn có, và cách bạn sẽ đo lường sự thành công.
Học có giám sát hoạt động như thế nào
Trong học có giám sát, mỗi dữ liệu huấn luyện bao gồm đầu vào và mục tiêu đã biết. Mô hình so sánh đầu ra của mình với mục tiêu, đo lường sai số, và cập nhật bản thân để giảm thiểu sai số đó. Quá trình này được lặp lại trên nhiều dữ liệu mẫu, giúp mô hình học được cách ánh xạ từ đầu vào đến kết quả.
Có hai hình thức phổ biến:
- Phân loại (Classification) dự đoán một danh mục, chẳng hạn như email có phải là thư rác hay hình ảnh có chứa mèo hay không.
- Hồi quy (Regression) dự đoán một đại lượng, chẳng hạn như giá nhà, nhu cầu năng lượng, hoặc nhiệt độ.
Một ví dụ thực tế là phát hiện gian lận. Ngân hàng có thể cung cấp các giao dịch lịch sử đã được gán nhãn là hợp pháp hoặc gian lận. Mô hình học có giám sát học được sự kết hợp nào giữa số tiền, địa điểm, thời gian, và loại nhà bán lẻ liên quan đến từng nhãn. Khi có giao dịch mới, mô hình sẽ gán điểm rủi ro giúp nhân viên thẩm định quyết định điều tra trường hợp nào.
Ví dụ khác là sàng lọc hình ảnh y tế. Nếu các bác sĩ X-quang đã đánh dấu các bản quét là có hoặc không có một tình trạng nhất định, mô hình có thể học từ các nhãn đó và đánh dấu các trường hợp cần xem xét kỹ hơn. Mô hình không thay thế bác sĩ; nó giúp ưu tiên sự chú ý và làm cho công việc chuyên môn trở nên nhất quán hơn.
Ưu điểm của học có giám sát
- Hiệu suất có thể được đo lường trực tiếp so với các câu trả lời đã biết.
- Các mô hình rất phù hợp cho các quyết định rõ ràng với danh mục hoặc giá trị được xác định.
- Kết quả thường dễ giải thích hơn khi các đặc trưng và nhãn được hiểu rõ.
Hạn chế của học có giám sát
Nhãn dữ liệu rất tốn kém. Ai đó phải tạo chúng một cách chính xác, và lỗi trong nhãn có thể dạy mô hình sai mẫu. Học có giám sát cũng có xu hướng tái tạo thói quen của dữ liệu mà nó được huấn luyện, vì vậy các ví dụ thiên vị hoặc lỗi thời có thể dẫn đến dự đoán thiên vị hoặc lỗi thời. Cuối cùng, nó chỉ có thể nhận ra các kết quả được đại diện trong dữ liệu huấn luyện; nó có thể gặp khó khăn khi điều kiện thay đổi đột ngột.
Học không giám sát hoạt động như thế nào
Học không giám sát không có đáp án. Hệ thống kiểm tra đầu vào và tìm kiếm các quy luật như nhóm, sự tương phản, hoặc các biểu diễn nén. Vì không có đầu ra đúng duy nhất, việc đánh giá dựa trên các thước đo như sự ổn định của cụm, sự phân tách, chất lượng tái tạo, hoặc tính hữu ích cho một tác vụ sau đó.
Các hình thức phổ biến bao gồm:
- Phân cụm (Clustering) nhóm các mục tương tự lại với nhau.
- Giảm chiều (Dimensionality reduction) đơn giản hóa nhiều biến thành ít thành phần có ý nghĩa hơn.
- Khám phá liên kết (Association discovery) tìm các mục thường xuất hiện cùng nhau.
Một ví dụ thực tế là phân khúc khách hàng. Nhà bán lẻ có thể nhóm người mua sắm dựa trên hành vi duyệt web, tần suất mua hàng, và sở thích sản phẩm mà không cần gán phân khúc thủ công trước. Các nhóm kết quả có thể tiết lộ người mua tập trung vào ngân sách, khách thỉnh thoảng ghé thăm, hoặc khách hàng trung thành. Nhà tiếp thị sau đó có thể tùy chỉnh thông điệp và kiểm tra xem phân khúc nào phản hồi tốt hơn với một ưu đãi so với ưu đãi khác.
Ví dụ khác là phát hiện bất thường trong sản xuất. Cảm biến trên dây chuyền sản xuất tạo ra nhiều dữ liệu đọc nhưng không có nhãn cho mỗi lỗi. Mô hình không giám sát có thể học được hoạt động bình thường trông như thế nào và làm nổi bật các dữ liệu đọc bất thường so với mẫu đó. Kỹ sư có thể kiểm tra các cảnh báo này và quyết định trường hợp nào cần hành động.
Ưu điểm của học không giám sát
- Nó hoạt động khi nhãn không có sẵn hoặc quá tốn kém để thu thập.
- Nó có thể tiết lộ cấu trúc ẩn mà con người chưa lường trước.
- Nó hữu ích cho việc khám phá, làm sạch dữ liệu, và tìm các trường hợp hiếm.
Hạn chế của học không giám sát
Kết quả có thể mơ hồ. Các thiết lập khác nhau có thể tạo ra các nhóm khác nhau, và các nhóm đó có thể không khớp với ý nghĩa kinh doanh hoặc khoa học. Các mô hình không giám sát cũng có thể khuếch đại nhiễu nếu dữ liệu chứa lỗi hoặc biến không liên quan. Vì không có mục tiêu cố định, việc so sánh các phương pháp đòi hỏi sự đánh giá cẩn thận và kiến thức chuyên môn.
Học có giám sát vs không giám sát: So sánh thực tế
Hãy xem xét một đội ngũ hỗ trợ muốn phân loại các yêu cầu đến. Nếu các yêu cầu trong quá khứ đã được gán cho các phòng ban, bộ phân loại học có giám sát có thể học từ các nhãn đó và gợi ý hàng đợi phù hợp cho các thông báo mới. Nếu không có nhãn, phân cụm có thể tổ chức các yêu cầu theo cách diễn đạt và chủ đề để nhóm có thể xem xét trước khi tạo các tuyến phân loại.
Hãy xem xét một dự án nghiên cứu về phản hồi của khách hàng. Phân tích cảm xúc học có giám sát có thể đánh dấu các bình luận là tích cực, tiêu cực, hoặc trung tính khi có dữ liệu huấn luyện. Mô hình hóa chủ đề không giám sát có thể khám phá các chủ đề lặp đi lặp lại như giao hàng, giá cả, hoặc chất lượng sản phẩm, ngay cả khi không ai xác định chúng trước.
Lựa chọn cũng phụ thuộc vào rủi ro. Khi dự đoán sai có hậu quả nghiêm trọng, dữ liệu có nhãn và độ chính xác có thể đo lường được rất có giá trị, điều này ủng hộ học có giám sát. Khi mục đích là hiểu một tập dữ liệu mới, nhãn học có giám sát có thể chưa tồn tại, vì vậy khám phá không giám sát là bước khởi đầu hợp lý.
Khi nào nên sử dụng từng phương pháp
Chọn học có giám sát khi
- Bạn có biến mục tiêu rõ ràng và đủ nhãn đáng tin cậy.
- Bạn cần đưa ra các dự đoán hoặc quyết định có thể lặp lại.
- Bạn có thể đánh giá độ chính xác, sai số, hoặc các thước đo khác so với kết quả đã biết.
Chọn học không giám sát khi
- Bạn cần khám phá dữ liệu trước khi xác định các danh mục.
- Nhãn bị thiếu, khó thu thập, hoặc không nhất quán.
- Mục ti��u của bạn là phân khúc, nén, phát hiện bất thường, hoặc tìm mẫu.
Một lộ trình cân bằng
Nhiều dự án thực tế kết hợp cả hai cách tiếp cận. Đội ngũ có thể bắt đầu với học không giám sát để làm sạch dữ liệu, tìm các nhóm tự nhiên, và xác định các đặc trưng hữu ích. Sau đó, họ sử dụng một mẫu nhỏ có nhãn để huấn luyện và đánh giá mô hình học có giám sát. Khi có dự đoán mới, kết quả có thể trở thành nhãn cho việc huấn luyện trong tương lai, miễn là con người xem xét chúng về chất lượng.
Nguyên tắc thực tế rất đơn giản: sử dụng học có giám sát khi bạn biết câu trả lời muốn có và có thể đưa ra ví dụ về nó. Sử dụng học không giám sát khi bạn cần dữ liệu tiết lộ điều quan trọng trước tiên. Bắt đầu với câu hỏi đúng, kiểm tra chất lượng dữ liệu, và kiểm tra kết quả so với kết quả thực tế sẽ quan trọng hơn việc chọn một thuật toán thời thượng.