Xử lý ngôn ngữ tự nhiên hoạt động như thế nào từng bước: Tokenization, Embeddings và Attention
Trí tuệ nhân tạo có thể dịch một đoạn văn, tóm tắt cuộc họp hoặc trả lời câu hỏi bằng ngôn ngữ tự nhiên. Tuy nhiên, máy không “nhìn” ngôn ngữ như con người. Nó nhận một chuỗi ký hiệu, chuyển chúng thành số, rồi tính toán phần nào của chuỗi là quan trọng nhất cho tác vụ hiện tại. Để hiểu xử lý ngôn ngữ tự nhiên hoạt động như thế nào từng bước, hãy theo dõi một câu từ văn bản thô đến câu trả lời được tạo ra.
Bước 1: Biến văn bản thành token
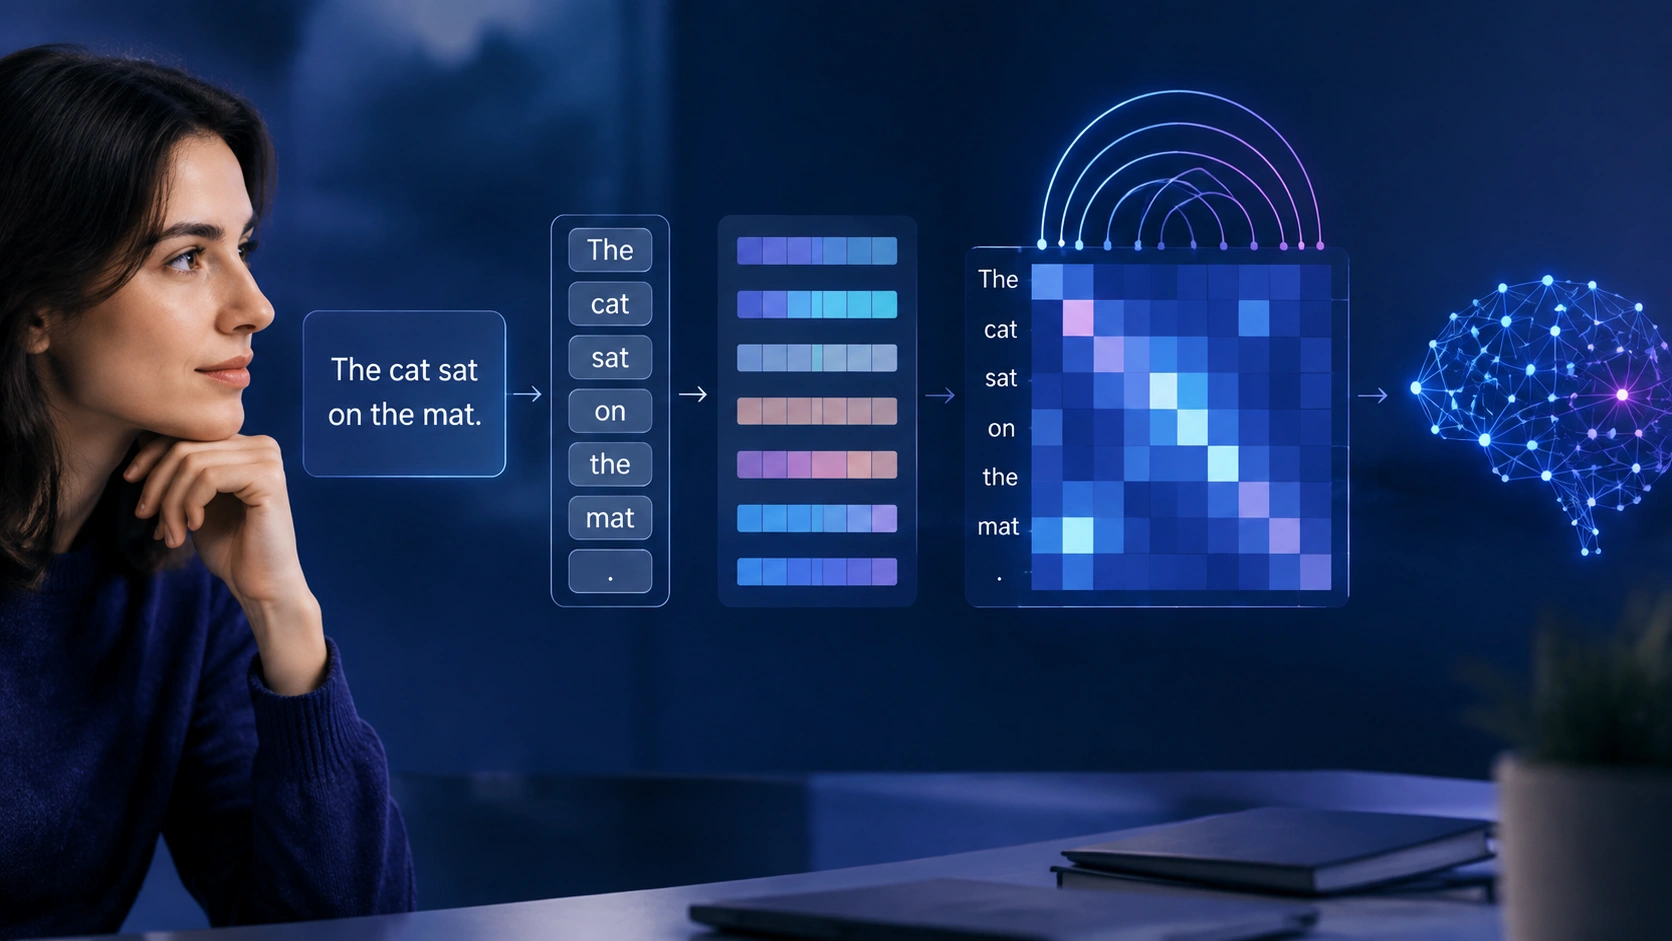
Bước đầu tiên là tokenization. Mô hình chia văn bản thành các đơn vị nhỏ gọi là token. Một token có thể là cả từ, một phần của từ, dấu câu hoặc thậm chí khoảng trắng. Ví dụ, câu Cats sleep. có thể trở thành các token Cats, sleep và .. Việc chia từ thành các mảnh cũng giúp mô hình xử lý các dạng hiếm như unbelievable bằng cách nhận diện các phần có nghĩa nhỏ hơn.
Mỗi token được ánh xạ đến một số nguyên trong từ vựng cố định. Từ vựng này được tạo trong quá trình huấn luyện và xác định phạm vi mà mô hình có thể biểu diễn trực tiếp. Nếu từ bị viết sai hoặc chưa từng gặp, tokenizer thường có thể chia nó thành các mảnh quen thuộc thay vì coi nó là vô nghĩa.
Tokenization không chỉ là công việc định dạng. Nó ảnh hưởng đến lượng ngữ cảnh mà mô hình có thể xử lý, hiệu suất chạy và khả năng xử lý tên riêng, số liệu, mã nguồn và các văn bản chuyên biệt khác. Một câu trở thành một chuỗi ID — cầu nối đầu tiên từ ngôn ngữ sang toán học.
Bước 2: Cho token ý nghĩa số học
Con số đơn thuần không cho mô hình biết rằng king và queen có liên quan. Bước tiếp theo là chuyển mỗi ID token thành một embedding — một danh sách số biểu diễn token trong không gian nhiều chiều. Các ý nghĩa tương tự thường nằm gần nhau, trong khi các ý nghĩa không liên quan thì cách xa hơn.
Embedding được học trong quá trình huấn luyện. Mô hình điều chỉnh chúng để dự đoán chính xác hơn trên hàng triệu ví dụ. Ngữ cảnh thay đổi biểu diễn: từ bank trong câu về sông nên được đặt khác với bank trong câu về tài chính. Do đó, các mô hình ngôn ngữ hiện đại tạo embedding theo ngữ cảnh thay vì dựa vào một vector cố định cho mỗi từ.
Hãy nghĩ embedding như tọa độ trên bản đồ khái niệm. Các trục không có nhãn đơn giản của con người, nhưng khoảng cách và hướng mã hóa các mối quan hệ hữu ích. Nhờ vậy, mô hình có thể so sánh các cụm từ, nhóm từ đồng nghĩa và suy luận về sự tương đồng mà không cần một từ điển định nghĩa rõ ràng.
Bước 3: Quyết định điều gì quan trọng bằng attention
Khi các token đã có embedding, mô hình phải hiểu mối quan hệ giữa chúng. Đây là lúc attention phát huy tác dụng. Với mỗi token, attention tính toán mức độ mà nó nên “lắng nghe” các token khác trong chuỗi. Kết quả là một tập hợp trọng số cho biết từ nào đang liên quan tại thời điểm hiện tại.
Trong câu The dog chased the ball because it was fast, để giải nghĩa it cần nhìn lại các danh từ gần đó và vai trò của chúng. Attention giúp mô hình so sánh đại từ với các từ ứng viên và gán trọng số lớn hơn cho từ làm cho câu có nghĩa. Cơ chế này cũng hỗ trợ các phụ thuộc khoảng cách xa, chẳng hạn như khớp một câu hỏi với một sự thật cách xa nhiều mệnh đề.
Attention được tính toán song song trên tất cả vị trí. Mỗi token tạo ra một query, một key và một value. Query hỏi token hiện tại cần gì, key mô tả các token khác cung cấp gì, và value mang thông tin sẽ được kết hợp. Khớp query với key tạo ra trọng số, và các value có trọng số trở thành biểu diễn được cập nhật của token. Việc xếp chồng nhiều lớp attention giúp mô hình xây dựng các quan điểm ngày càng trừu tượng về ngữ pháp, ý định và chủ đề.
Bước 4: Thêm cấu trúc và ngữ cảnh
Attention đơn lẻ chưa đủ. Mô hình cũng thêm thông tin vị trí để biết thứ tự của các token. Nếu không có nó, dog bites man và man bites dog sẽ trông giống nhau. Tín hiệu vị trí có thể là các mẫu cố định hoặc vector được học, và chúng được kết hợp với embedding trước khi attention chạy.
Giữa các lớp attention, các khối mạng neural biến đổi biểu diễn của mỗi token, nắm bắt các mẫu cục bộ và chuẩn bị cho vòng so sánh tiếp theo. Các kết nối residual và chuẩn hóa giúp việc huấn luyện ổn định. Sau nhiều lớp như vậy, mỗi vị trí lưu giữ một bản tóm tắt phong phú về câu và ngữ cảnh của nó.
Bước 5: Sinh ngôn ngữ
Với các tác vụ hiểu, mô hình có thể biến biểu diễn cuối cùng thành nhãn, điểm số hoặc câu trả lời. Với tác vụ sinh, nó dự đoán token tiếp theo. Vector cuối cùng cho vị trí hiện tại được ánh xạ đến xác suất trên toàn bộ từ vựng. Hệ thống sau đó chọn một token, thêm nó vào chuỗi và lặp lại quá trình.
Các thiết lập sampling ảnh hưởng đến kết quả. Lựa chọn xác suất cao tạo ra văn bản dễ đoán, trong khi cho phép các lựa chọn xác suất thấp hơn thêm sự đa dạng. Mô hình không trích xuất một câu đã viết sẵn; nó xây dựng câu từng bước, sử dụng ngữ cảnh ngày càng lớn để hướng dẫn mỗi quyết định. Đây là lý do tại sao một thay đổi nhỏ ở từ đầu có thể làm thay đổi mọi thứ phía sau.
Quá trình không đảm bảo điều gì
Mô hình ngôn ngữ là hệ thống học mẫu, không phải cơ sở dữ liệu sự thật. Nó có thể tạo ra văn bản trôi chảy nghe có vẻ tự tin ngay cả khi sai. Kiến thức của nó được định hình bởi dữ liệu huấn luyện và câu trả lời phụ thuộc vào ngữ cảnh được cung cấp trong prompt. Đánh giá, kiểm tra của con người và các nguồn đáng tin cậy vẫn rất quan trọng khi hậu quả lớn.
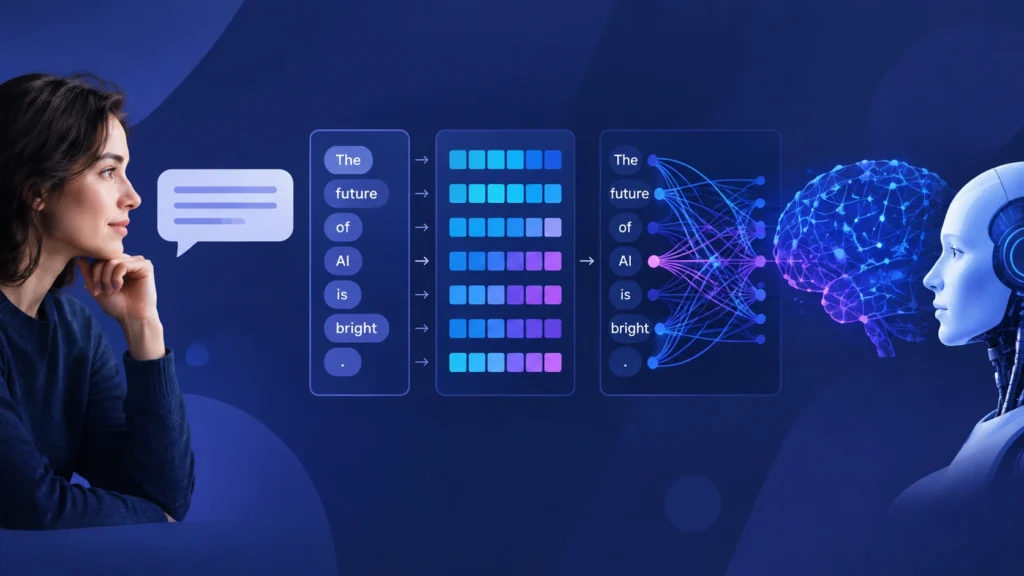
Tokenization, embedding, attention và quá trình sinh tạo thành một pipeline chứ không phải các kỹ thuật biệt lập. Token cung cấp đơn vị, embedding cung cấp ý nghĩa, attention cung cấp sự tập trung và decoding cung cấp đầu ra. Nhìn pipeline theo thứ tự giúp hành vi của các công cụ AI hàng ngày bớt bí ẩn và dễ sử dụng hơn.